
「Webサイトを作ったのに、誰も見に来てくれない」「広告費をかけずに、どうすればお客様を集められるのだろうか?」現在でも、こうした悩みを抱えている中小企業の経営者やWeb担当者は少なくありません。Googleで検索順位が上がらなければアクセスが増えず、最近ではAI検索の普及によって、これからどのように集客すればよいのかわからなくなっている方もいるでしょう。
では、Googleがまだ日本で広く使われていなかった約30年前の企業は、どうやってWebサイトにアクセスを集めていたのでしょうか。
実は1998年頃の日本では、Yahoo! JAPANなどの検索エンジンへの登録申請、他のWebサイトとの相互リンク、リンク集への掲載、メールマガジン、雑誌や新聞での紹介などが重要な集客手段でした。現在のようなSNSもYouTubeも存在せず、Google広告もまだ始まっていない時代です。
Webサイトの運営者たちは、試行錯誤しながら自分のサイトを知ってもらう方法を探していたのです。
興味深いのは、当時の集客方法には、現在では通用しなくなったものがある一方で、AI検索時代にも役立つ考え方が数多く含まれていることです。特に、他の人から紹介してもらうことや、訪問者が繰り返し見に来たくなる情報を提供することは、約30年が経過した現在でも大切です。今回は当時の報道やWebサイト運営者の記録をもとに、Google以前のWeb集客の実態を振り返ります。
1998年のWebサイト運営者は、なぜアクセスを集めるのに苦労していたのか?
1998年は、Windows 98が発売され、日本でもインターネットが急速に普及し始めた年です。しかし、当時のインターネット利用者数は現在と比べると非常に少ないものでした。郵政省の調査によると、1998年末の日本のインターネット利用者数は1,694万人、人口普及率は13.4%でした。つまり、多くの人はまだ日常生活の中でインターネットを利用していなかったのです。
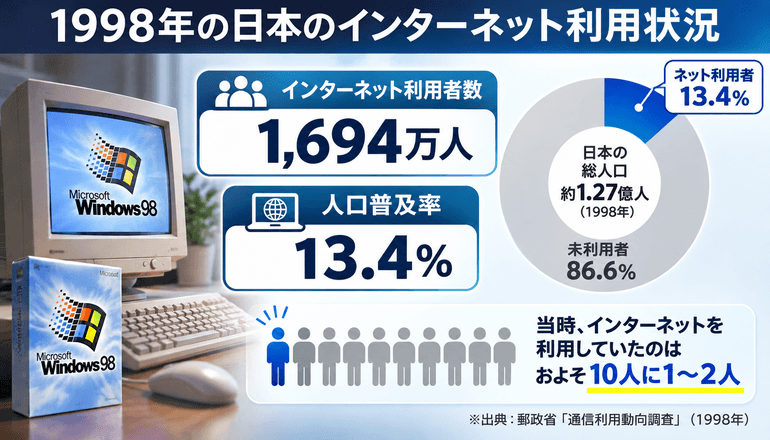
《出典》インターネット利用者数及び人口普及率の推移(総務省「通信利用動向調査」に基づく政府資料)
現在なら、飲食店を探すときにGoogleマップを開いたり、商品を購入する前に検索したりすることが当たり前になっています。しかし当時は、商品やサービスを探すためにインターネットを利用する人自体が限られていました。企業がWebサイトを開設しても、それだけで新しいお客様が次々と訪問してくれる環境ではなかったのです。
さらに大きな問題は、自社のWebサイトを知ってもらう手段が限られていたことです。現在では、SNSに投稿すればフォロワーに知らせることができますし、検索広告を利用すれば、特定のキーワードで情報を探している人に広告を表示できます。しかし1998年には、こうした仕組みが十分に整っていませんでした。
そのため、Webサイトの運営者は、まず自分たちの存在をインターネット利用者に知ってもらう必要がありました。企業のWebサイトでも、個人の趣味のサイトでも、最初の課題は同じです。どれほど役立つ情報を掲載していても、その存在を知られていなければ、誰も訪問してくれなかったのです。
検索エンジンへの登録申請は、なぜ重要なアクセスアップ対策だったのか?
当時のWebサイト運営者にとって、最初に取り組むべきアクセスアップ対策の一つが、検索エンジンへの登録申請でした。
前回までの記事で紹介したように、1998年の日本では、Yahoo! JAPAN、goo、Infoseek、Exciteなど、複数の検索サービスが競争していました。検索サービスによって、Webサイトを人間が分類するディレクトリ型検索と、プログラムがWebページを自動収集するロボット型検索があり、Webサイトの発見方法は異なっていました。
そのため、Webサイト運営者は、それぞれの検索サービスの特徴を調べ、必要に応じて登録申請を行っていました。例えばYahoo! JAPANのディレクトリに掲載してもらうには、適切なカテゴリにWebサイトを推薦する必要がありました。一方、ロボット型検索では、プログラムに自分のWebページを発見してもらうことが重要でした。
現在のSEOでは、Googleにページが認識されているかをGoogle Search Consoleなどで調べることができます。しかし当時は、このような管理環境が一般に提供されておらず、Webサイト運営者は各検索サービスの登録方法を調べながら対応していたのです。
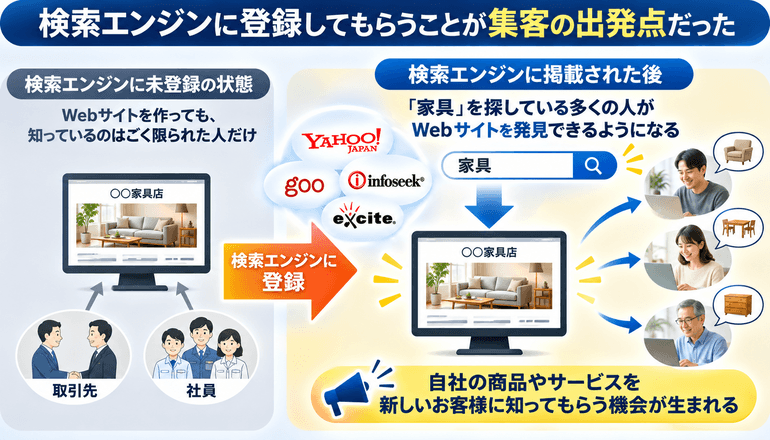
1. 検索エンジンに登録してもらうことが集客の出発点だった
例えば、地方で家具を販売している企業がWebサイトを開設したとしましょう。当時、そのWebサイトの存在を知っているのは、取引先や社員など、ごく限られた人たちだったかもしれません。しかし検索エンジンに掲載されれば、家具を探している人がそのWebサイトを発見する可能性が生まれます。
これは説明のための例ですが、検索エンジンへの登録には、そのような価値がありました。Webサイトを作成しただけでは接点を持てなかった人々に、自社の商品やサービスを知ってもらう機会が生まれたのです。
当時の実情を示す貴重な資料があります。1999年7月19日、『INTERNET Watch』は「ホームページにカウンターをつけよう」という特集記事を掲載しました。この記事ではアクセス数を増やす方法として、Yahoo!などの検索サイトへの登録や、メーリングリストなどでメールを送る際に署名へURLを記載することが紹介されています。
《出典》ホームページにカウンターをつけよう(INTERNET Watch、1999年7月19日)
この記録から、当時のアクセスアップ対策がどのようなものだったのかを具体的に知ることができます。検索順位を細かく分析する以前に、まず自分のWebサイトが存在することを、できる限り多くの人に知らせることが大切だったのです。
2. 複数の検索エンジンに対応する必要があった
当時のWeb集客で面倒だったのは、検索エンジンが一つではなかったことです。Yahoo! JAPANに登録されていても、別の検索エンジンで同じように発見してもらえるとは限りませんでした。そのため、利用者がどの検索サービスを使っているのかを考え、複数の検索エンジンへの対応を検討する必要がありました。
これは現在のAI検索時代と似ている部分があります。今後、企業はGoogle検索だけでなく、AIモード、ChatGPT、地図サービス、SNSなど、さまざまな場所から発見してもらうことを考える必要があります。
ただし、当時の検索エンジンへの登録申請と、現在のAI検索に取り上げてもらう仕組みは異なります。同じ登録方法が通用するということではなく、利用者が情報を探す場所の変化に対応するという考え方が共通しているのです。
相互リンクはなぜ1990年代後半のWebサイトで広まったのか?
当時のWebサイトでは、「リンク集」というページをよく見かけました。リンク集とは、他のWebサイトへのリンクをまとめたページのことです。現在ではあまり見かけなくなりましたが、1990年代後半から2000年代初頭のWebサイトでは、一般的な構成要素の一つでした。
例えば、犬の飼育に関する個人サイトなら、犬の健康情報、しつけ、動物病院、ペット用品などに関するサイトを紹介するリンク集が考えられます。利用者はリンクをたどることで、最初に訪問したWebサイトとは別の情報に出会うことができました。
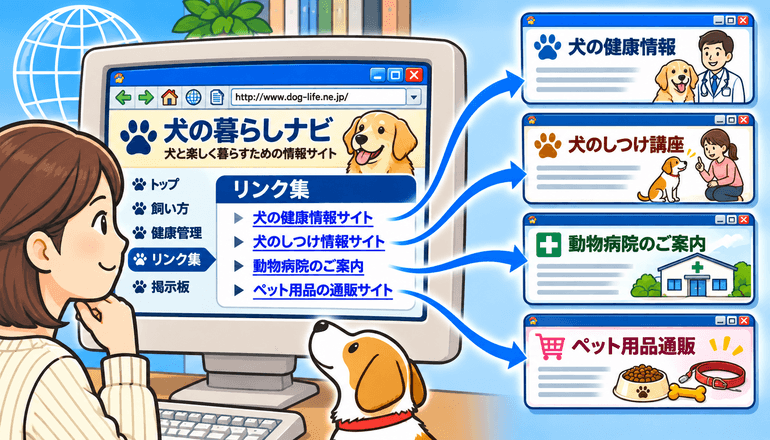
現在のSNSでは、人々は投稿を共有したり、他のアカウントを紹介したりすることで情報を広めています。それに対して当時のWebサイトでは、リンクを設置することが、他の運営者や利用者とのつながりを作る重要な方法だったのです。
1. 相互リンクはWebサイト同士の紹介活動だった
相互リンクとは、二つのWebサイトが互いにリンクを設置することです。例えば、AというWebサイトがBを紹介し、BもAを紹介するという仕組みです。
当時の相互リンクには、検索順位を上げるためのSEO技術という意味だけでなく、関連するWebサイト同士で訪問者を紹介し合うという役割がありました。特に同じ分野の情報を扱うWebサイトであれば、相手のサイトから訪問してくれた人が、自分のサイトにも興味を持ってくれる可能性があります。
2016年にITmediaが掲載した「昔のホームページにあった『リンク集』を完全再現してみた」という記事には、当時の個人サイト文化が詳しく紹介されています。そこでは、リンク集が、現在のSNSに近い役割を持つ人間関係の接点でもあったことが説明されています。
《出典》昔のホームページにあった「リンク集」を完全再現してみた(ITmedia PC USER、2016年9月5日)
つまり、当時のリンク集には、情報を整理する役割と、人と人をつなぐ役割の両方があったのです。Webサイト同士がリンクを設置することで、それまで存在を知らなかった利用者に新しい情報を届けることができました。
2. リンク集は単なるアクセスアップ対策ではなかった
さらに興味深いのは、リンク集そのものが情報サービスとして成立していたことです。
例えば、ある分野について優れたWebサイトを集め、わかりやすく分類して紹介すれば、そのリンク集を訪問するだけで、利用者は必要な情報を見つけやすくなります。これは現在の比較サイトや専門情報サイトにも通じる考え方です。
実際に、日本の個人Webサイト文化を調べた記録には、1995年に「日記リンクス」という個人の日記サイトを集めたリンク集が誕生したことが紹介されています。このリンク集では、登録された日記の更新情報を利用者が確認できる仕組みがありました。単にリンクを並べるだけでなく、どのWebサイトに新しい情報が追加されたのかを知ることができたのです。
《出典》登録型ウェブ日記リンク集の動乱(佐倉葉ウェブ文化研究室、2020年)
この記録を見ると、1990年代のWebサイト運営者が、現在のSNSや情報ポータルに近い仕組みを、自分たちなりに工夫して作っていたことがわかります。
ただし、後年、検索順位を操作するためだけに大量の相互リンクを設置する手法が広まったこととは区別する必要があります。もともと利用者に役立つサイトを紹介するためのリンクと、検索アルゴリズムを操作することを主な目的としたリンクは、その目的が異なるからです。
雑誌にWebサイトを紹介してもらうことが、なぜ集客につながったのか?
1998年当時のWeb集客を考えるうえで、忘れてはならないのが紙の雑誌です。
今ではWebサイトのURLを雑誌で調べることは少なくなりましたが、1990年代後半には、インターネット関連の雑誌やWebサイト紹介書籍が重要な情報源でした。読者は雑誌に掲載されたWebサイトの説明を読み、興味を持ったサイトのURLをブラウザに入力して訪問していたのです。
当時は、どのWebサイトが面白いのか、どのサイトに役立つ情報が掲載されているのかを、検索エンジンだけで十分に見つけられるとは限りませんでした。そこで、雑誌の編集者が選んだWebサイトを紹介する書籍や特集記事に価値がありました。
1. WebサイトのURLを集めた書籍が販売されていた
1998年12月には、アスキーから『厳選日本のホームページ10万 99年版』という書籍が発売されていました。この書籍は、国内の約28万サイトから情報収集に役立つ10万サイトを選び、24のジャンル、約7,400の分類に整理したURL集でした。
また、日本経済新聞社からは『日経インターネットイエローページ1999』が発売され、国内企業・団体約35,000件のURLや住所、電話番号などが収録されていました。
これらの出版物の存在は、当時のインターネット利用者が、紙の書籍を使ってWebサイトを探していたことを示しています。
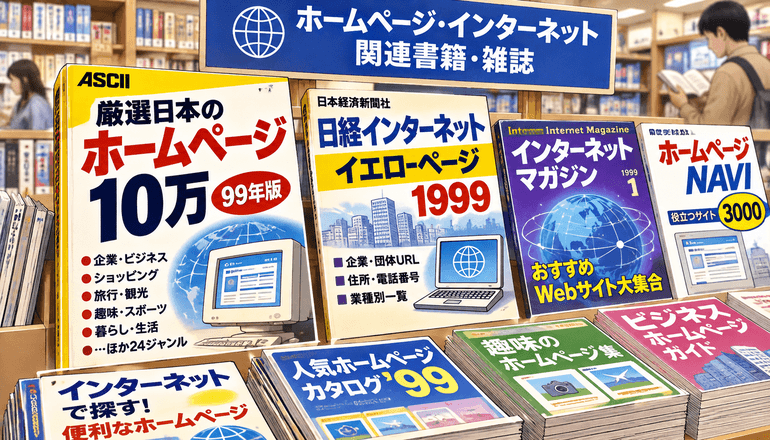
《出典》掲載記録・1998年(検索デスク、当時の雑誌掲載履歴)
現在では、10万サイトのURLが掲載された本を購入してWebサイトを探すことは、ほとんど考えられません。しかし、当時はそれほどまでに、役立つWebサイトを探すこと自体に価値があったのです。
企業の立場から考えると、こうした書籍や雑誌で紹介されることは、新しい利用者との接点になる可能性がありました。検索エンジンに登録してもらうことだけでなく、編集者に取り上げてもらうことも、Webサイトを知ってもらう方法だったのです。
2. 個人のWebサイトでも雑誌に掲載される機会があった
当時のWebサイトが雑誌で紹介されていた実例も残っています。
例えば、個人サイト「Lucky Dip!」には、1998年から1999年にかけて雑誌などで紹介された記録が掲載されています。1998年には『SOHOコンピューティング』『日経ネットナビ』『週刊アスキー』『TECH Win』など、複数の媒体に紹介されたことが記録されています。
さらに1999年には、各種パソコン雑誌や生活情報誌などにも掲載されています。記録には、自宅へ記者やカメラマンが取材に訪れたことなども書かれています。
《出典》雑誌・メディア紹介(Lucky Dip!、Webサイト運営者による掲載履歴)
この事例が興味深いのは、大企業でなくても、独自の内容を持つWebサイトであれば、さまざまなメディアに取り上げられる機会があったことです。ただし、この掲載履歴だけで、どの雑誌から何人の訪問者が集まったのかまではわかりません。
それでも、当時のWebサイト運営者が、検索エンジン以外の経路からも存在を知られる機会を得ていたことを示す、貴重な記録です。
メールマガジンやメールの署名も重要な集客手段だった
現在ではSNSや動画配信を利用して情報を発信する企業が増えていますが、1990年代後半には電子メールが重要なコミュニケーション手段でした。
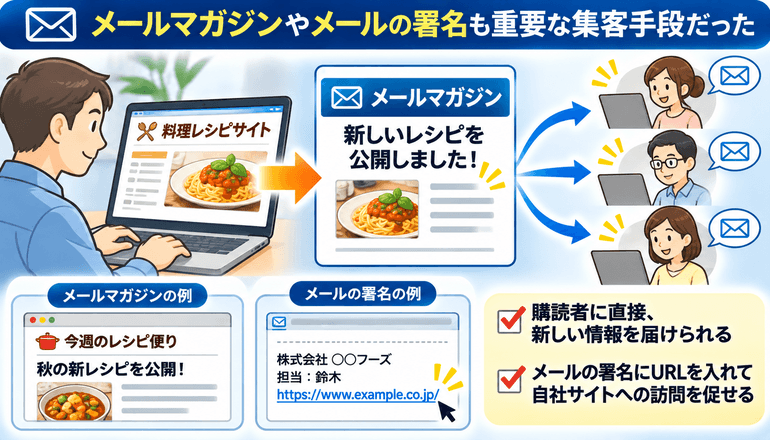
特にメールマガジンは、継続的に情報を届けるための手段として利用されていました。メールマガジンとは、登録した読者に対して電子メールで情報を配信する仕組みです。
Webサイトの場合、利用者が自分からアクセスしなければ情報を見てもらえません。しかしメールマガジンなら、購読を希望して登録した人に、新しい情報を直接届けることができます。
例えば、料理に関するWebサイトなら、新しいレシピを公開したことをメールで知らせることができます。専門的な情報を提供するWebサイトなら、新しい解説記事や業界ニュースをメールで紹介することもできます。
1. メールの末尾にURLを入れることがアクセスアップ対策だった
当時のアクセスアップ対策には、現在では当たり前になったような小さな工夫もありました。
その一つが、電子メールの署名にWebサイトのURLを掲載することです。仕事上のメールやメーリングリストへの投稿などで、自分の名前や連絡先とともにWebサイトのURLを記載しておけば、メールを読んだ相手が興味を持って訪問してくれる可能性があります。
1999年の『INTERNET Watch』の記事でも、この方法がアクセスアップの手段として紹介されていました。現在のSEO対策と比べると非常に地道な方法ですが、当時はこうした小さな機会を積み重ねることが重要だったのです。
ただし、メールを送りつければよいということではありません。関係のない相手に大量のメールを送ることは、当時でも迷惑になる行為でした。必要としている人に役立つ情報を届けることが、継続的な関係を作るために重要だったのです。
2. 一度訪問した人に、また来てもらうことが重要だった
当時のWebサイト運営者にとって、もう一つ大きな問題がありました。それは、一度訪問してもらえても、その人が二度目に訪問してくれるとは限らないことです。
検索エンジンに登録されたり、雑誌で紹介されたりして、一時的にアクセスが増えることはあったでしょう。しかし、訪問した人がそのWebサイトに価値を感じなければ、再び訪問する理由はありません。
1999年の『INTERNET Watch』の記事でも、Webサイトの存在を多くの人に知らせるだけでなく、再び訪問したくなるコンテンツを提供する必要があると説明されています。
これは現在のWeb集客でも非常に重要な考え方です。Google検索やAI検索から一度アクセスしてもらうだけではなく、役立つ情報を継続的に提供し、自社を覚えてもらうことが、長期的な集客につながる可能性があるからです。
アクセスカウンターの数字に一喜一憂していた時代
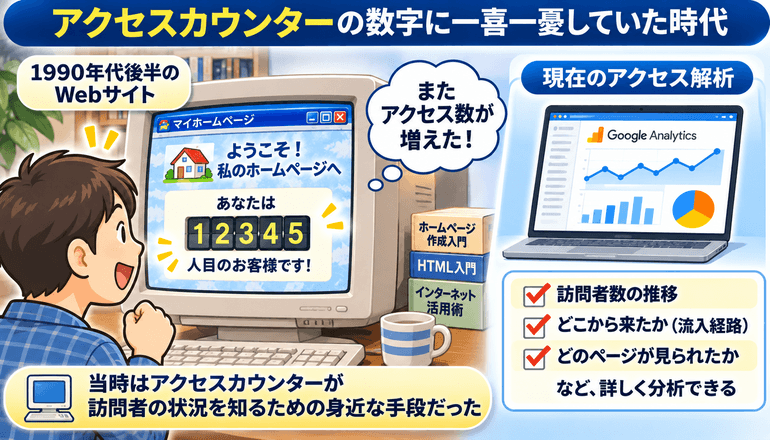
1990年代後半のWebサイトで、非常によく見かけたものがあります。それがアクセスカウンターです。「あなたは12345人目のお客様です」というような表示を覚えている方もいるのではないでしょうか。アクセスカウンターは、Webページが表示された回数などを数値として表示する仕組みです。
現在では、Google Analyticsなどのアクセス解析ツールを利用すれば、訪問者数や流入経路、閲覧されたページなどを詳しく分析できます。しかし、当時の個人サイトでは、アクセスカウンターが訪問状況を知るための身近な手段でした。
1999年7月の『INTERNET Watch』では、無料のアクセスカウンターサービスや、自分でカウンターを設置する方法が詳しく紹介されていました。さらに、アクセスした人の参照元などを調べるアクセス解析サービスについても説明されています。
《出典》ホームページにカウンターをつけよう(INTERNET Watch、1999年7月19日)
この記録を見ると、当時からWebサイト運営者がアクセス数を気にしていたことがわかります。今日のアクセス数が昨日より増えたのか、どのような対策をしたときに訪問者が増えたのかを知りたいという気持ちは、現在のWeb担当者と変わりません。
ただし、アクセスカウンターの数字には注意が必要でした。カウンターの仕組みによっては同じ人が何度もアクセスすると数字が増えることがあり、表示されている数値が実際の訪問者数を正確に示しているとは限らなかったからです。
この点も、現在のWeb集客に通じます。アクセス数が増えることと、売上が増えることは同じではありません。何人の人が訪問したかだけでなく、その人たちが何を求め、最終的にどのような行動を取ったのかを考えることが重要なのです。
相互リンクはなぜ後にSEOの問題になったのか?
ここまで紹介してきた相互リンクやリンク集は、もともと関連するWebサイトを紹介し、利用者が新しい情報を見つけられるようにするための仕組みでした。
しかし、GoogleがWebページ同士のリンク構造を検索順位の評価に活用するようになると、リンクの意味が変化していきました。
Googleの創業者であるラリー・ペイジとサーゲイ・ブリンが1998年に発表した研究論文では、Webページ間のリンク構造を利用してページの重要性を判断する考え方が説明されています。後にPageRankとして広く知られる技術です。
《出典》The Anatomy of a Large-Scale Hypertextual Web Search Engine(Sergey Brin・Lawrence Page、1998年)
Googleがリンクを評価に活用したことで、他のWebサイトからリンクしてもらうことには、アクセスを送ってもらうという本来の役割に加え、検索順位への影響という新しい意味が生まれました。
その結果、2000年代には、検索順位を上げることを目的にリンクを大量に獲得する対策が注目されるようになります。相互リンクも、単なるWebサイト同士の紹介活動ではなく、SEO対策として利用される場面が増えていきました。
しかし、リンクの数を増やすことだけが目的になると、利用者にとって役立たないリンク集が作られるようになります。関連性の乏しいWebサイト同士が、検索順位を上げるためだけにリンクし合うような対策です。
現在のGoogleは、検索順位を操作することを主な目的とした過剰な相互リンクや、価値の低いディレクトリからのリンクを、リンクスパムの例として挙げています。
《出典》Google ウェブ検索のスパムに関するポリシー(Google Search Central、公式ドキュメント)
ただし、相互リンクそのものがすべて問題だというわけではありません。関連する企業や団体、役立つ情報を持つWebサイトを、利用者のために紹介することには現在でも意味があります。
問題になるのは、利用者の利便性ではなく、検索順位の操作を主な目的としてリンクを増やすことです。この違いを理解するためにも、1990年代後半のリンク集文化を知っておくことには価値があると思います。
Google以前のWeb集客から、現在のAI検索時代に何を学べるのか?
1998年頃のWeb集客を振り返ると、検索エンジンへの登録申請、相互リンク、雑誌での紹介、メールマガジンなど、実にさまざまな方法が使われていたことがわかります。
興味深いのは、その多くが、検索順位を上げるという技術的な発想だけで成り立っていたわけではないということです。企業や個人が、自分たちのWebサイトを必要としている人に知ってもらうために、さまざまな場所で情報を発信し、他の人から紹介してもらおうとしていました。
現在では、Google検索で上位表示することがWeb集客の中心になっている企業もあります。しかし、AI検索の普及によって、利用者が必ずしも検索結果に表示されたWebサイトを訪問するとは限らなくなってきました。
そこで、私は1998年頃のWeb集客から、三つの重要な教訓を学べると考えています。
1. 検索順位だけに頼らず、自社を知ってもらう経路を増やすこと
1998年には、検索エンジンだけでなく、他のWebサイトからのリンクや雑誌などを通じてアクセスを集めていました。現在でも、業界団体のWebサイト、専門メディア、口コミ、SNS、YouTubeなど、自社を発見してもらえる経路を増やすことには意味があります。
特に、特定の検索サービスからのアクセスが減少したとき、他にも安定した集客経路があれば、事業への影響を抑えられる可能性があります。
2. 第三者から紹介される価値を理解すること
昔のリンク集や雑誌での紹介は、第三者がそのWebサイトを利用者に紹介する行為でした。現在でも、信頼できるメディアや取引先、業界団体などから紹介されることは、認知度の向上や新しい訪問者との接点につながる可能性があります。
ただし、第三者からの紹介が増えれば、必ずAI検索に引用されるというわけではありません。AI検索でどのような情報源が参照されるかは、質問内容やサービスの仕組みによって異なります。
それでも、自社が発信する情報だけに頼るのではなく、実際の活動や専門性を通じて第三者から自然に紹介される機会を作ることは、長期的なWeb集客の基盤になると考えられます。
3. 一度訪問した人に、再び選んでもらうこと
1999年のアクセスカウンターに関する記事でも指摘されていたように、Webサイトの存在を知ってもらうだけでは十分ではありません。利用者が再び訪問したくなる情報を提供することが、継続的なアクセスにつながります。
現在なら、定期的に役立つ記事を公開したり、メールマガジンで情報を届けたり、SNSや動画を使って専門知識を発信したりする方法があります。こうした取り組みは、検索順位の変動だけに左右されない関係を、利用者と築くためにも役立つでしょう。
まとめ:昔のアクセスアップ対策には、AI検索時代にも役立つ原点がある
1998年頃の日本では、Webサイトを作成しても、その存在を知ってもらうこと自体が大きな課題でした。
そのため、企業や個人のWebサイト運営者は、Yahoo! JAPANなどの検索エンジンへの登録申請、リンク集への掲載、相互リンク、メールマガジン、雑誌での紹介など、さまざまな方法でアクセスを集めようとしていました。
当時の資料を読むと、現在のSEO対策とは大きく異なる方法が使われていたことがわかります。しかし、その根底には、必要としている人に情報を届けたいという共通の目的がありました。
そしてもう一つ重要なのは、Webサイトを知ってもらうだけでなく、訪問者に満足してもらい、再び訪問してもらうことが大切だと、当時から考えられていたことです。
私は、これからのAI検索時代にも、この考え方が重要になると思っています。検索エンジンの仕組みは変わります。利用者が情報を探す方法も変わります。しかし、自社の商品やサービスを必要としている人に知ってもらい、信頼してもらい、選んでもらうというWeb集客の目的は変わりません。
約30年前のWebサイト運営者たちが取り組んでいた地道な活動を振り返ると、現在のAI検索対策でも、目先の技術だけを追いかけるのではなく、利用者との接点を増やし、継続的な関係を築くことが大切だと気づかされます。